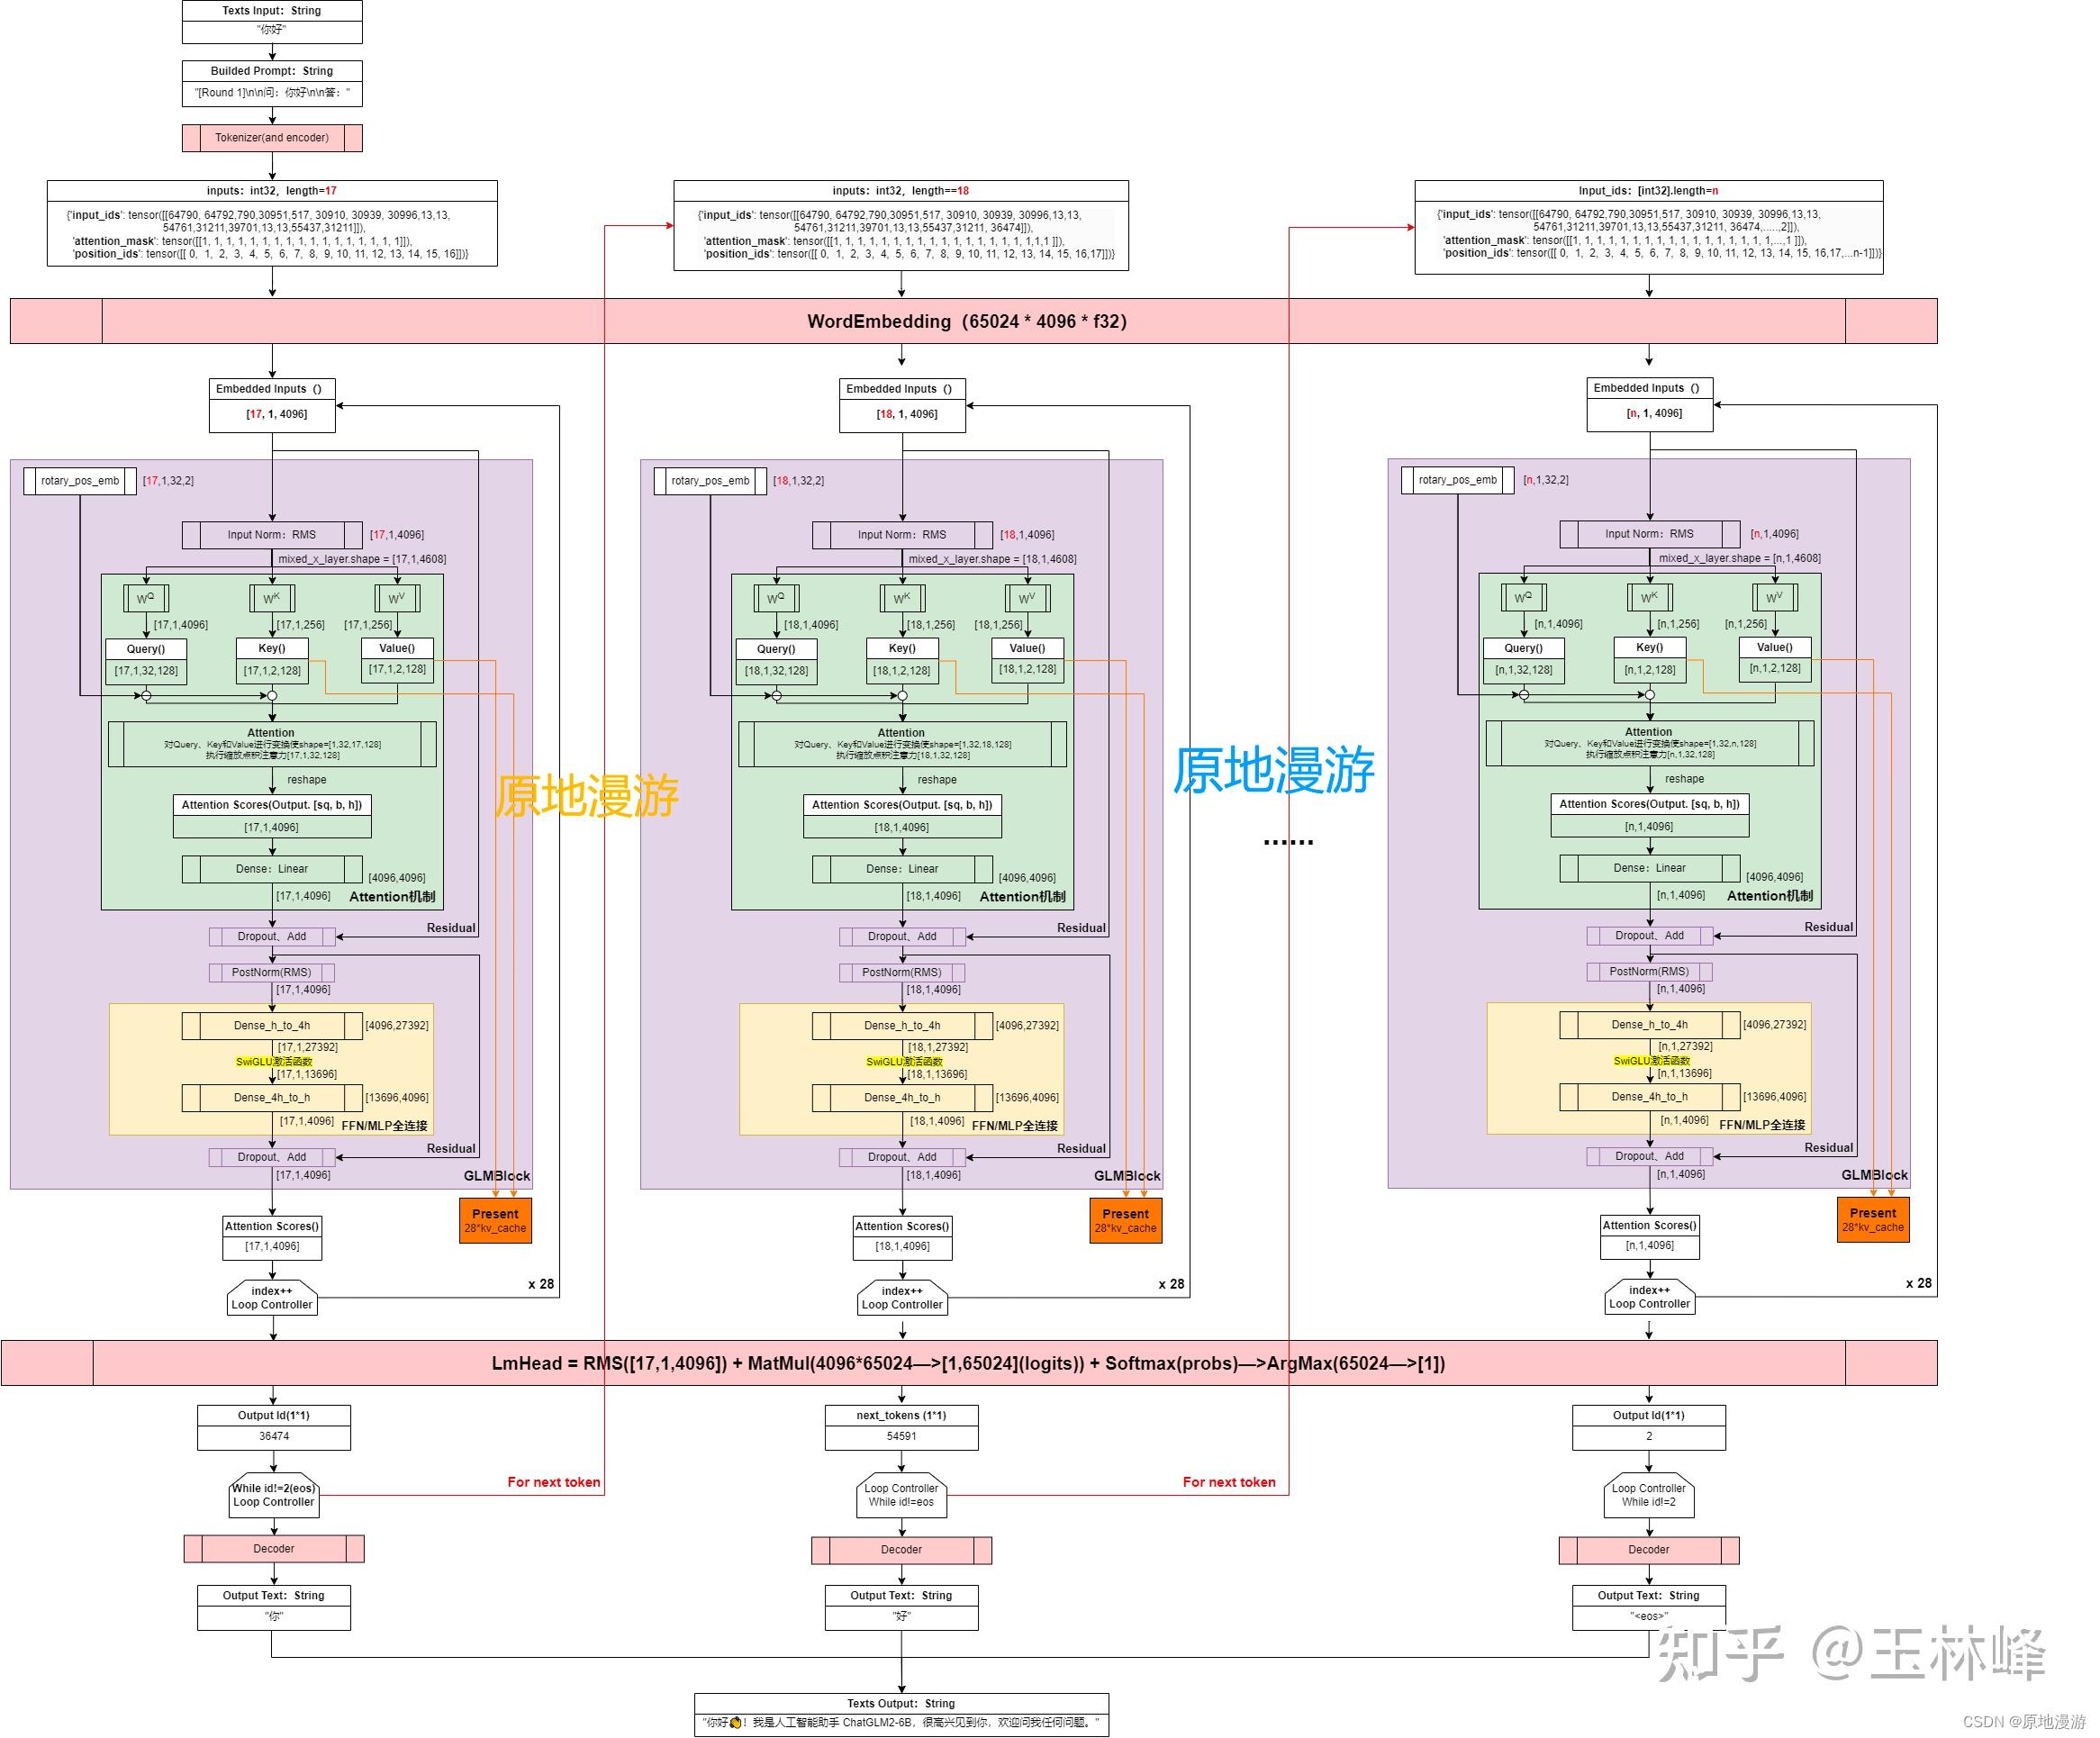
QKV如何计算屋顶菌:Transformer 1. Attention中的Q,K,V是什么 Ng 吴恩达老师的讲解:多头注意力机制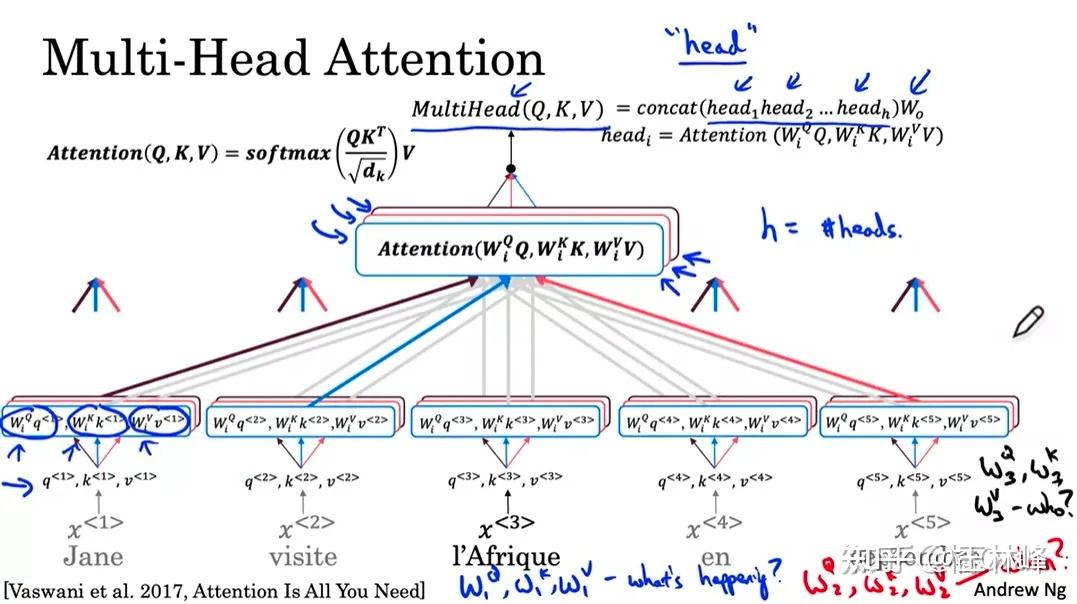 transformer中decoder注意力机制是Masked的。Transformer模型的encoder使用的是普通的self-attention机制,而decoder使用的是masked attention机制。
 transformer架构,但是图并不清晰
LLM Visualization
中文翻译:新智元:矩阵模拟!Transformer大模型3D可视化,GPT-3、Nano-GPT每一层清晰可见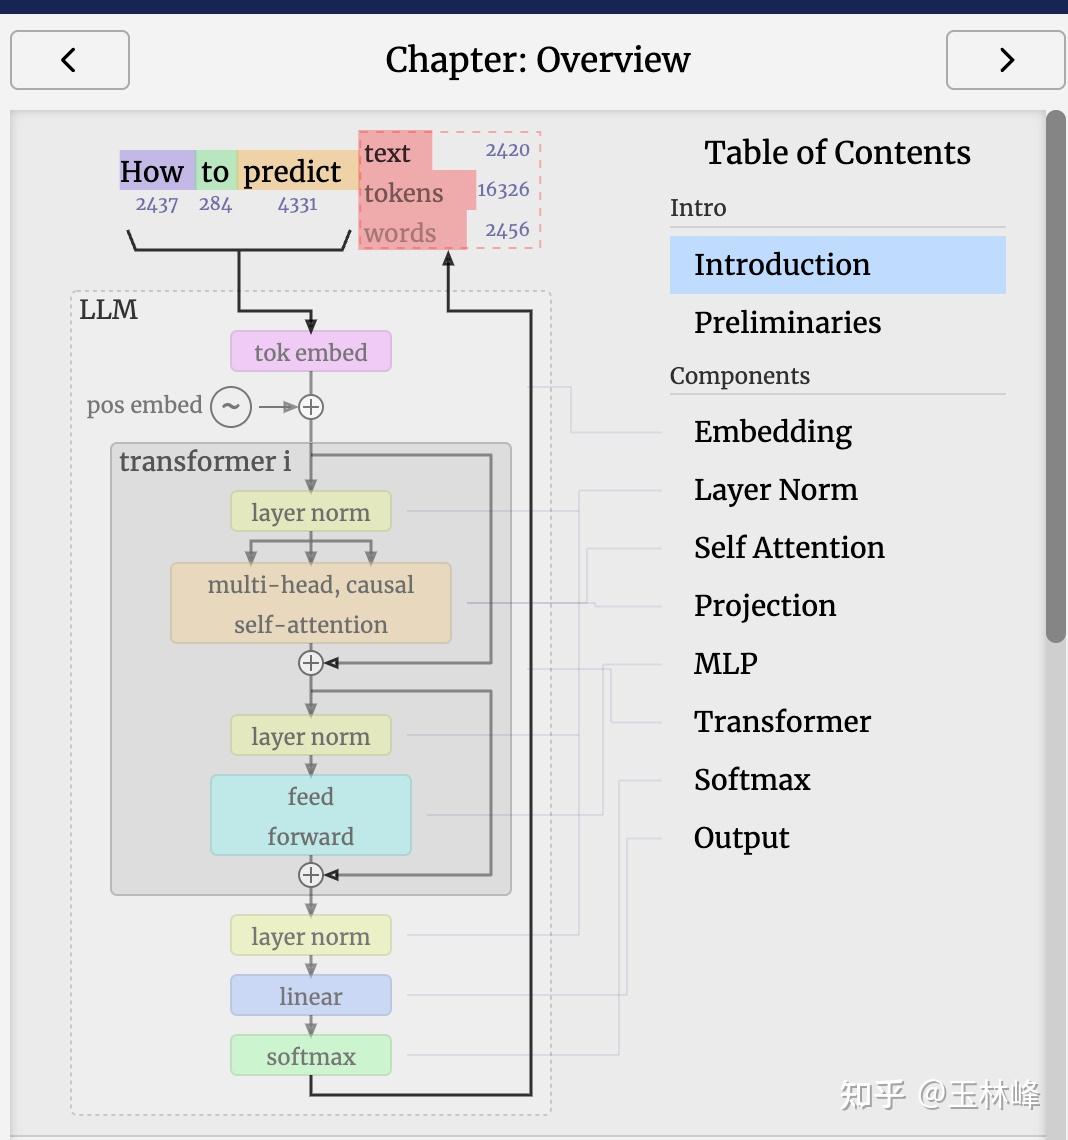 非常形象!
causal attention 就是跟masked 一个意思,只将query向量与过去的key向量进行运算,使得它成为因果自注意力。也就是说,token无法「预见未来」。
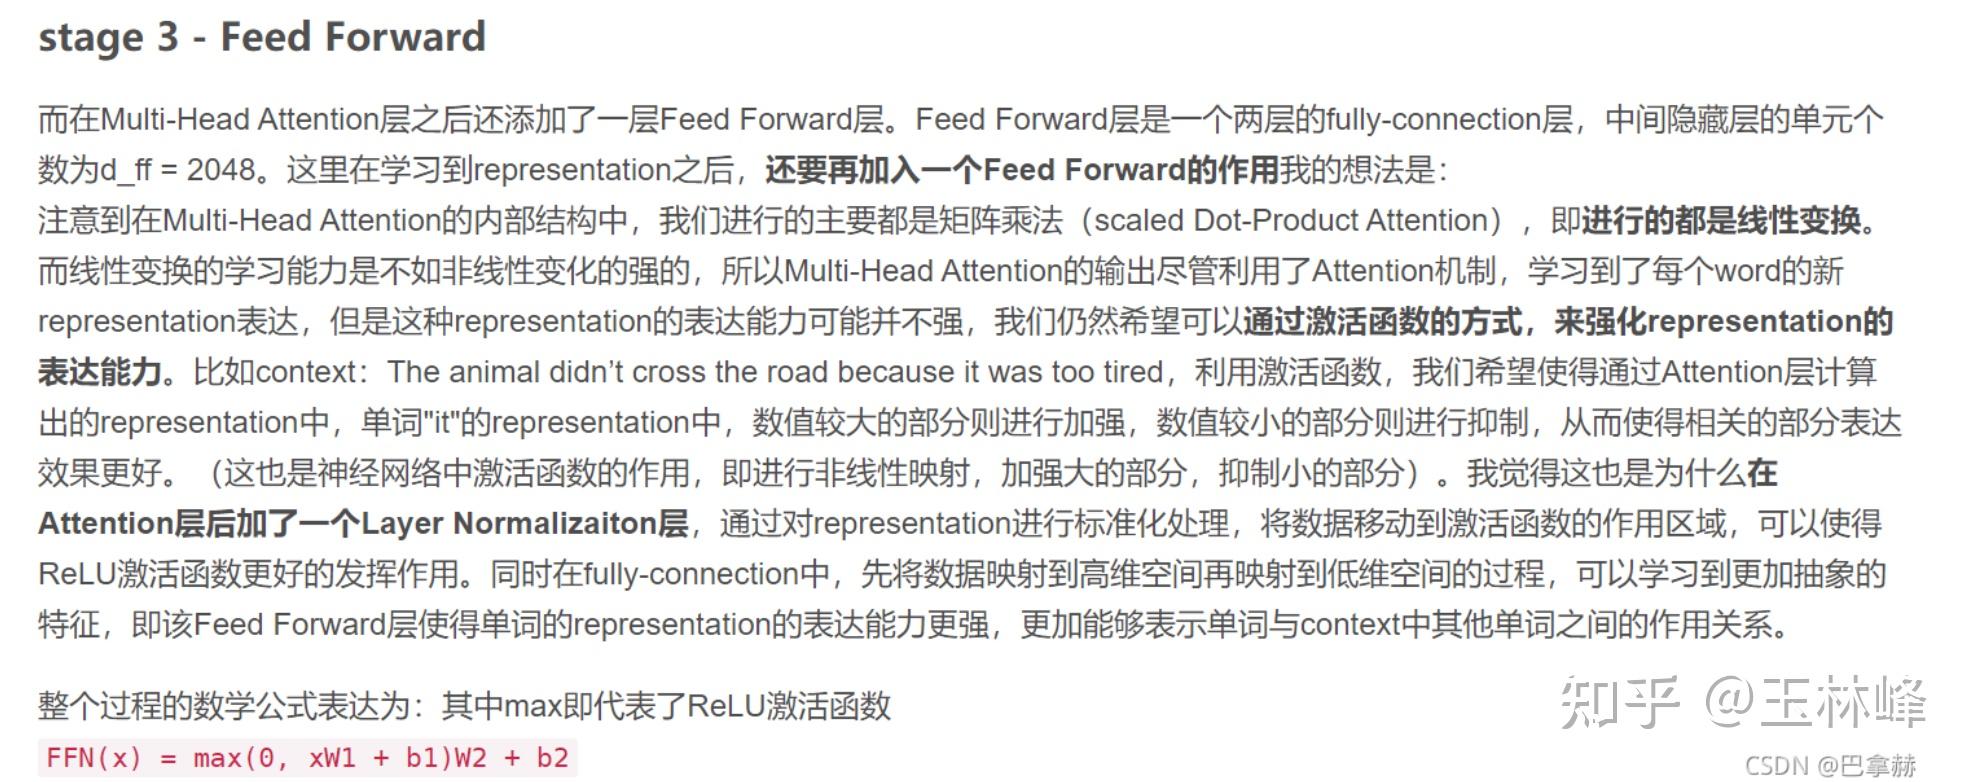 这个层的作用是将数据从较低维度空间(在您的例子中是4096维)扩展到更高维度空间(27392维)。这种扩展使得网络可以创建一个更高维度的表示空间,从而在这个空间中学习更复杂的特征和表示。在高维空间中,数据点更加分散,减少了各个特征之间的相互干扰,使模型能够更有效地学习数据中的复杂模式和关系。这一步骤可以类比于“思考”的过程,其中模型通过扩展数据维度来探索可能的特征组合和关系。经过数据扩展和处理后, 层的作用是将数据从高维空间(27392维)压缩回原始维度空间(4096维)。这种压缩有助于提炼和总结在高维空间中学习到的特征,把它们转换为更为紧凑和有效的表示。通过这种压缩,模型能够减少计算复杂度,并为后续的处理步骤生成一个更为精炼的特征表示。
参考:ChatGLM2-6B模型推理流程和模型架构详解-CSDN博客